Was steckt im PDF?
Original, Rohdaten und redaktionelle Zuordnung im direkten Vergleich.
Text, Bildobjekte und Positionen kommen aus Poppler. Artikelgrenzen und Werbeflächen sind kuratiert. Bildobjekte sind nicht gleich Fotos: Dazu zählen auch QR-Codes, Fragmente und Anzeigenbestandteile.
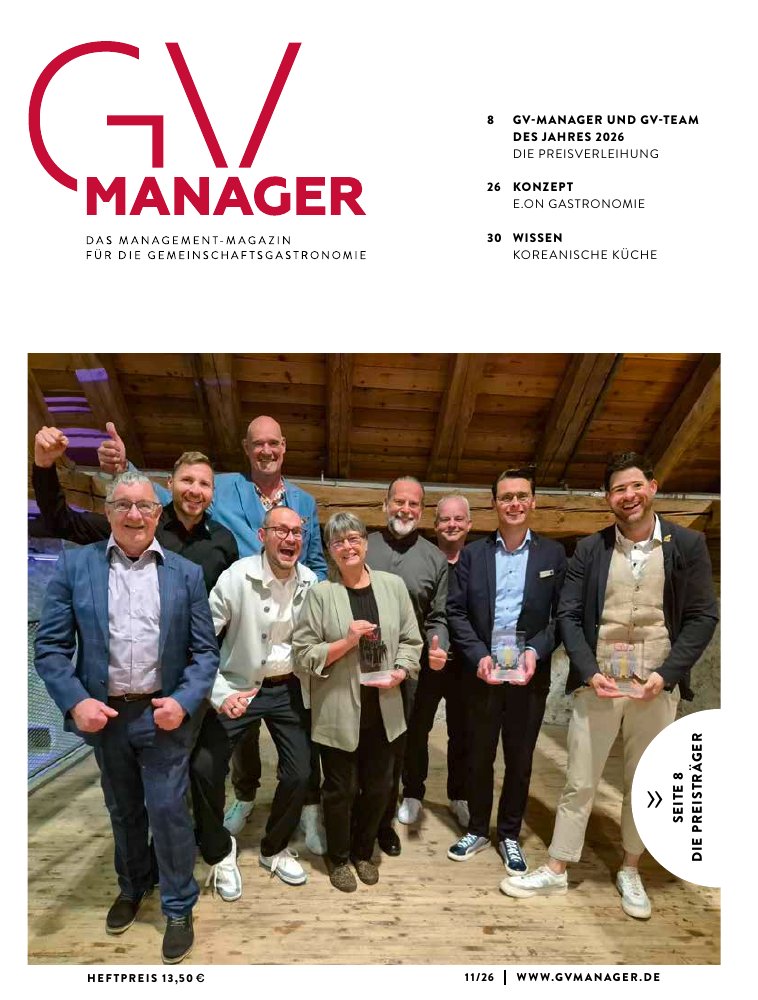
Titel der Ausgabe.
11/26 WWW.GVM ANAGER.DE
8 GV-MANAGER UND GV-TEAM
DES JAHRES 2026
DIE PREISVERLEIHUNG
26 KONZEPT
E.ON GASTRONOMIE
30 WISSEN
KOREANISCHE KÜCHE
HEF TPREIS 13,50
e
»
Was dieser Versuch zeigt
Schon maschinell verfügbar
Textblöcke, Schriftgrößen, Farben, Bildobjekte und Positionen. Die Bilder bleiben in ihrer eingebetteten Auflösung erhalten.
Noch redaktionelle Arbeit
Zusammenhängende Artikel, Lesereihenfolge, Bildnachweise und Anzeigenzuordnung. Verweise wie „s. QR-Code“ werden nicht durch erfundene Links ersetzt.
Bewusst nicht automatisch
Kein Umschreiben, keine Bildgenerierung, keine Veröffentlichung. Die Originaldatei bleibt unverändert. Die übrigen 39 Heftseiten sind nicht importiert.